Technologie
Ventes flash tech : 10 offres pour booster votre business digital
La rentrée est lancée, et avec elle, son lot de ventes flash Amazon. Mais cette année, arrêtez de voir ces promotions comme de simples achats personnels....
Découvrez nos derniers articles sur le développement web, le design et les technologies digitales qui façonnent l'avenir
La rentrée est lancée, et avec elle, son lot de ventes flash Amazon. Mais cette année, arrêtez de voir ces promotions comme de simples achats personnels....
Et si l’architecture qui équipe 99 % des smartphones du monde décidait soudainement de concurrencer ses propres clients ? C’est le scénario choc...
Depuis ce week-end, bonne nouvelle les zamis, puisque ce bon vieux ffmpeg sait maintenant fabriquer des images qui n'ont jamais été filmées. Oui oui ! Et ça c'est possible grâce à un filtre qui s'appelle fruc_vulkan, qui permet de calculer le mouvement entre deux images grâce au bloc dédié des...

Bull annonce qu'il livrera un supercaculateur LUMI-AI en Finlande. Le contrat est de 387,8 millions €. Il sera déployé dans le cadre du projet européen EuroHPC JU et LUMI AI Factory. Hébergé par le consortium LUMI AI Factory et déployé dans le centre de données de CSC à Kajaani, en Finlande,...
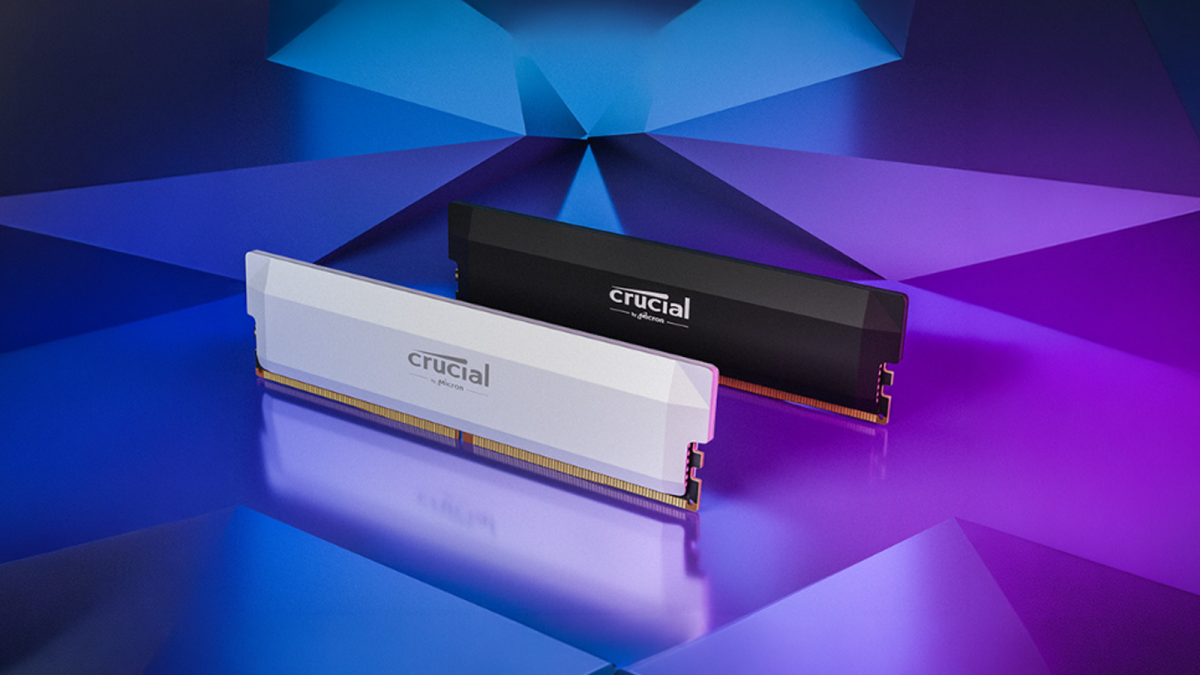
[TITRE] RAM DDR5 32 Go : Le prix idéal pour booster vos performances digitales [/TITRE] [CONTENU] Dans un marché où la flambée des prix des composants...
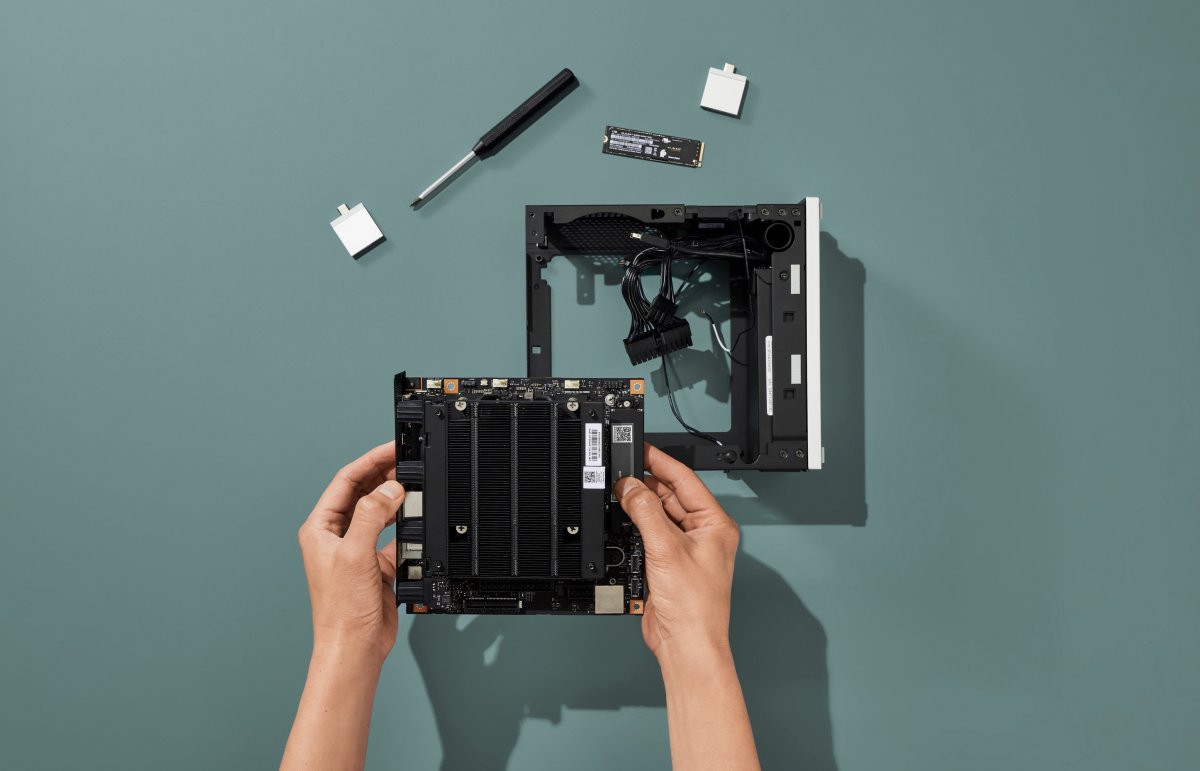
Framework mentionne désormais, sur la page officielle de son Framework Desktop, l'arrivée imminente d'une nouvelle option Ryzen AI Max+ PRO 495 pour son mini-PC modulaire. Cette puce AMD « Gorgon Halo » offre avant tout plus de mémoire vive embarquée et une bande passante plus généreuse. On fait le...

GraalVM annonce la version 25.3. Cette mise à jour se focalise sur les performances et la sécurité. 1 / performancesGraalVM 25.3 propose un nouveau "priority inliner". Il est disponible dans le JIT et Native Image. Il effectue une analyse du call graph pour optimiser les appels et donner la...
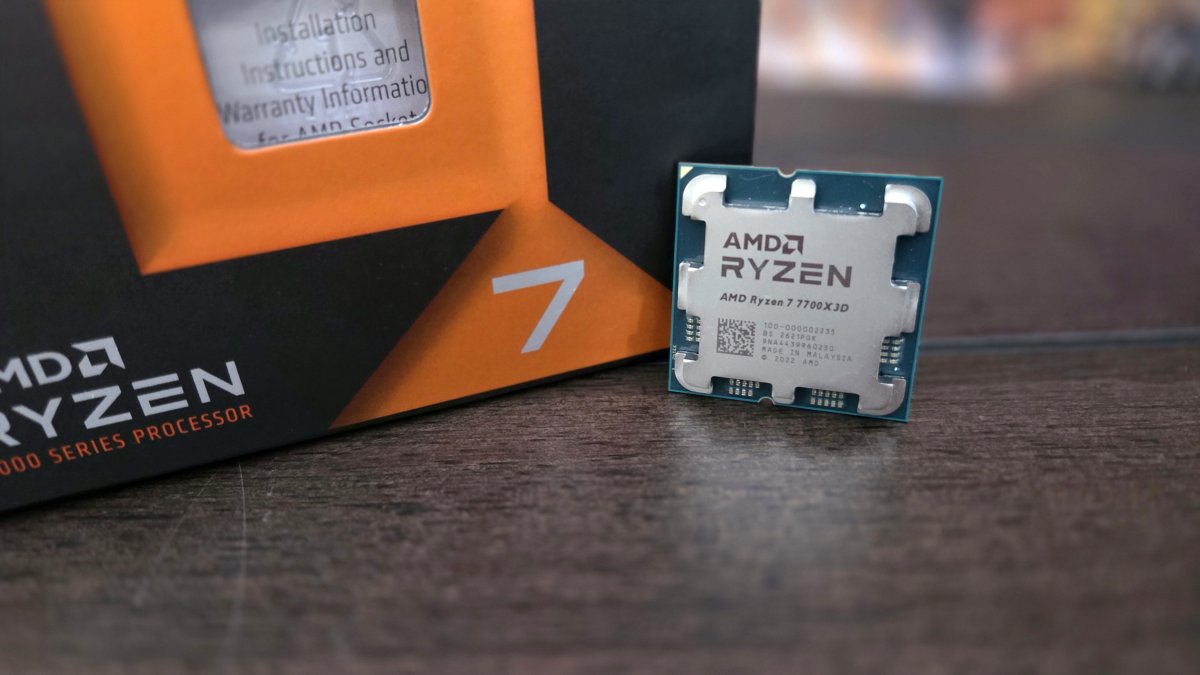
Soyons honnêtes, nous ne l’attendions pas vraiment ce Ryzen 7 7700X3D. Alors qu’AMD porte plutôt sa nouvelle génération de Ryzen 9000 en architecture Zen 5, c’est donc bien un processeur Zen 4 qui nous arrive à la faveur de cet été 2026 caniculaire. De quoi faire suer la concurrence ?
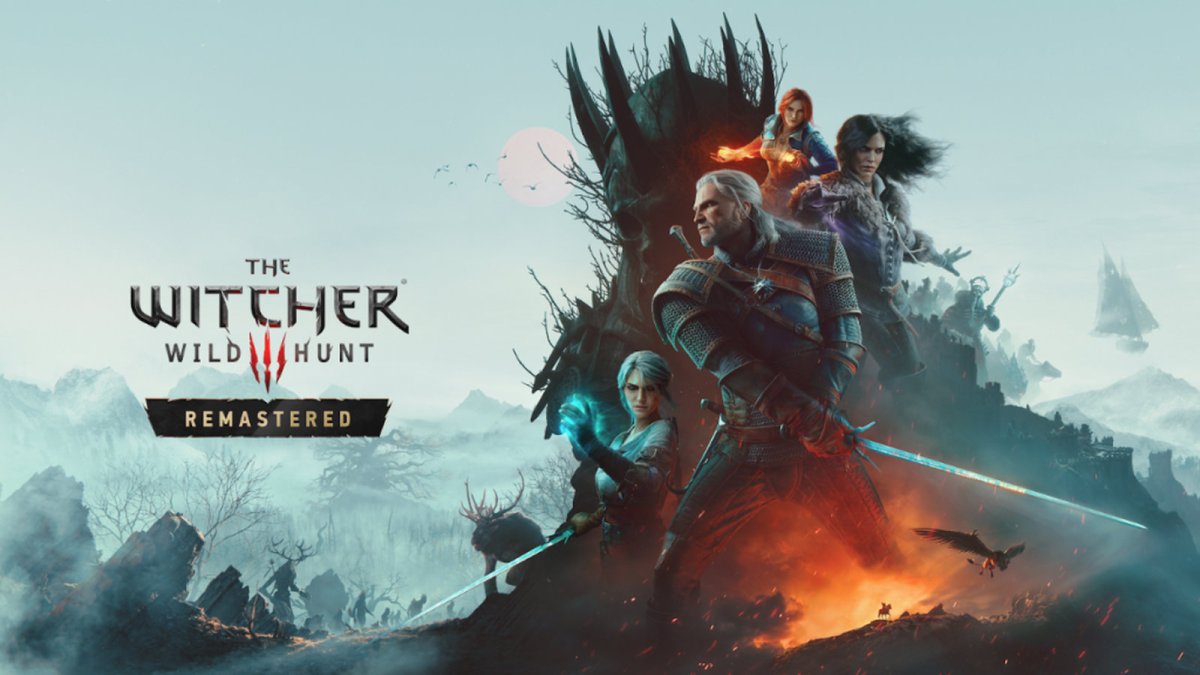
Le remaster de The Witcher 3 fait sensation avec ses technologies de pointe : path tracing, DLSS 4.5, FSR 4 et XeSS 2. Pour les entreprises marocaines, cette...
This is today’s edition of The Download, our weekday newsletter that provides a daily dose of what’s going on in the world of technology. Introducing: the Kids issue If the desire to limit kids’ use of technology was once a subcurrent, it has become a raging flood. Countries...
La puce accélératrice d’IA de l’éditeur de ChatGPT est sur le papier plus avantageuse que les GPU de Nvidia et AMD pour l’inférence. Elle devait au départ équiper les datacenters en propre d’OpenAI, mais la concrétisation de ceux-ci est devenue incertaine.
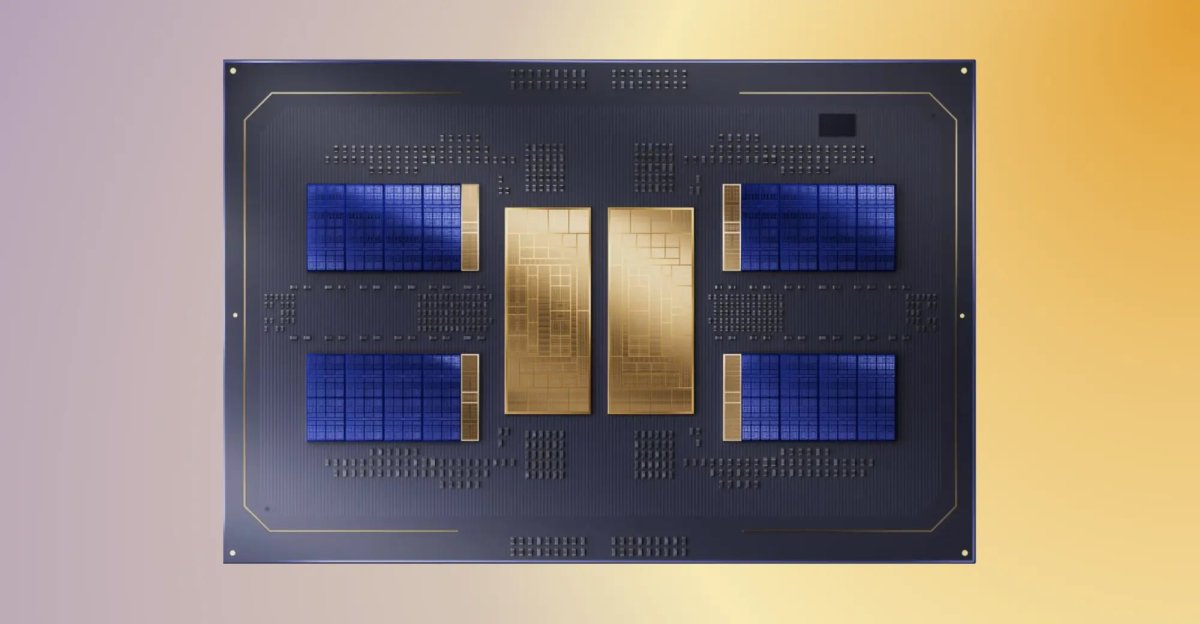
Concurrencé par AMD et ses processeurs EPYC, Intel se doit de réagir pour ne pas être complètement distancé dans les serveurs : Diamond Rapids constitue LA réponse du fondeur américain.